Google Domain Shared Contacts: Wenn das Verzeichnis voll ist, hilft auch Löschen nicht
Wir schreiben Kontakte aus Pipedrive in die Google Domain Shared Contacts. Das ist jenes Verzeichnis, das allen Mitarbeitenden in der Autovervollständigung erscheint, ohne dass es jemand in den eigenen Kontakten pflegen muss. Für ein Vertriebsteam ist das praktisch: Die Nummern aller Kund:innen sind auf jedem Firmentelefon hinterlegt.
Ein Fehler in unserem Sync liess dieses Verzeichnis auf 146'532 Einträge anwachsen. Der Fehler selbst ist unspektakulär und in zwei Sätzen erzählt: Der Client fragte 5000 Kontakte pro Anfrage an, Google liefert maximal 1500 pro Anfrage. Für die restlichen Kontakte waren separate Anfragen nötig. Kontakte, die nicht in den ersten 1500 existierenden Kontakt aufgelistet waren, sahen für unseren Sync so aus, als gäbe es sie nicht. Entsprechend wurden all diese Kontakte jede Nacht neu angelegt.
Interessant ist nicht der Fehler. Interessant ist, was danach passierte. Wir bemerkten den Fehler erst, als uns Google den Zugang zum API abstellte. Zu dem Zeitpunkt liess sich unser Kontaktverzeichnis nicht mehr aufräumen, und die Gründe dafür stehen in keiner Anleitung.
Was Domain Shared Contacts eigentlich sind
Die Domain Shared Contacts sind kein Teil der modernen People API, welche die normalen Google Kontakte bedient. Unsere Kontakte leben jedoch in der GData-Welt, einer Google-API-Generation aus den späten 2000ern, und werden über einen Atom-Feed bedient:
https://www.google.com/m8/feeds/contacts/{domain}/full
Bemerkenswert ist das {domain} in der URL.
Bei persönlichen Kontakten steht dort eine Mailadresse oder default.
Hier steht der Domainname, und die beiden anderen Varianten geben HTTP 400:
contacts/nxt.engineering/full   -> 200, 146'532 Einträge
contacts/default/full           -> 400
contacts/michael.gerber@.../full -> 400
Das ist der erste Hinweis darauf, dass man sich hier nicht in einem Postfach befindet, sondern in einem domainweiten Verzeichnis. Ein Gruppen-Feed existiert nicht. Es gibt also keine Labels, nach denen man filtern oder sortieren könnte, und damit auch keinen Weg, einen Teilbestand über einen einzigen Request zu löschen, um das Rate-Limit zu umgehen.
Zugriff braucht Domain-Admin-Rechte.
Praktischer Nebeneffekt: Ein Lesezugriff auf den Domain-Feed ist gleichzeitig ein Berechtigungstest.
Kommt 200, hat der Aufrufer Adminrechte auf dem Verzeichnis, kommt 403, hat er sie nicht.
Zwei Limits, und das falsche ist das bekanntere
Für Domain Shared Contacts gelten zwei Obergrenzen: 200'000 Kontakte und 40 MB Speicher. Beide stammen aus einem Ankündigungsposting von 2020, das die Werte heraufsetzte, von bisher 50'000 Kontakte oder 20 MB.
Die Kontaktzahl ist die bekanntere Grenze und in unserem Fall irrelevant gewesen. Mit 146'532 Einträgen lagen wir klar darunter. Massgeblich war der Speicher. 40 MB auf 146'532 Kontakte sind rund 286 Byte pro Eintrag. Ein Kontakt mit Name, Firma, Mail, Telefonnummer und einer 70 Zeichen langen Property-URL für die Pipedrive-ID liegt eher bei 300 bis 500 Byte.
Ab dem Moment, in dem das Limit fällt, antwortet jede schreibende Anfrage so:
{
  "error": {
    "code": 403,
    "message": "Storage quota exceeded",
    "status": "PERMISSION_DENIED"
  }
}
Lesen funktioniert weiter, uneingeschränkt. Nur Schreiben nicht.
Der Deadlock: Löschen ist auch Schreiben
Die naheliegende Reaktion ist, Kontakte zu löschen. Doch auch das ging nicht. Der Grund dafür war für uns jedoch nicht sofort nachvollziehbar.
Ein Delete entfernt den Kontakt nicht, er ersetzt ihn durch einen sogenannten Tombstone.
Dieser Grabstein bleibt rund 30 Tage liegen,
damit synchronisierende Clients erfahren, dass der Kontakt nun gelöscht ist.
Sichtbar wird das über showdeleted=true:
live:            107'318
inkl. gelöscht:  146'597
Die Summe bleibt konstant. Jede Löschung verschiebt einen Eintrag von der einen in die andere Spalte, und der Tombstone belegt weiterhin Platz. Das Löschen eines Kontaktes fügt dem Kontakt also etwa 115 Byte hinzu!
In der Praxis bedeutet das: Pro Anlauf kamen rund 70 Löschungen durch, dann war wieder zu. Am nächsten Tag wieder 67. Bei 140'000 Duplikaten würde das zu viel Zeit in Anspruch nehmen.
Ein voller Store kann sich also nicht selbst leeren. Das ist die unangenehmste Eigenschaft dieser Schnittstelle.
Kein Weg über die Oberfläche
Bevor wir einen Weg gefunden hatten, der funktionierte, haben wir auch einiges ausprobiert, das nicht funktionierte.
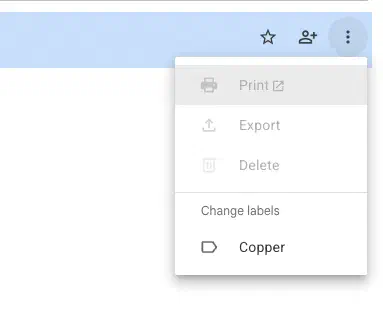
Die Kontakte-Oberfläche. Das Verzeichnis erscheint dort unter «Verzeichnis», aber read-only. Der Löschen-Knopf ist grau, und zwar unabhängig vom Speicherstand. Das ist Absicht und kein Symptom des vollen Stores. Wer diesen grauen Knopf in ein Support-Ticket schreibt, bekommt zu Recht «works as intended» zurück.
Die Admin-Konsole. Die Verwaltung der Shared Contacts wurde vor Jahren entfernt. Es gibt dort keinen Ort, an dem man diesen Bestand sieht oder bearbeitet.
GAM.
GAM ist ein quelloffenes Kommandozeilenwerkzeug,
mit dem sich Google Workspace administrieren lässt:
User, Gruppen, Drive, Kalender und eben auch Kontakte.
Naheliegend, weil GAM für fast alles in Workspace eine Antwort hat,
und gam delete contacts existiert tatsächlich.
Nur benutzt GAM denselben m8/feeds-Endpoint.
Gleiche URL, gleiches 403.
Ein anderer Client hilft nicht, wenn die Grenze am Store hängt und nicht am Aufrufer.
Der Ausweg: verkleinern statt löschen
Die Frage, die weiterhalf, war: Was können wir tun, um den Speicher zu reduzieren? Da ein Löschbefehl einen Tombstone erzeugt und den Speicherverbraucht erhöht, funktioniert das nicht für sich alleine.
Die Antwort ist: Ein Update.
Das Ändern der Kontakt hinterlässt keinen Grabstein.
Wir konnten per PUT die Kontakt überschrieben und dabei Informationen entfernen.
Somit wurde Speicher frei.
Wir haben unsere Duplikate deshalb zuerst abgemagert: Mail, Telefon und Organisation raus, Name und Pipedrive-ID bleiben. Pro Kontakt sind das 1833 Byte vorher und 401 Byte nachher.
Damit ergibt sich ein Hebel: 3000 verkleinerte Kontakte haben 37'468 Löschungen finanziert. Rund 1:12. Und sobald genug Luft vorhanden ist, ändert sich das Tempo grundlegend.
Drei Zyklen aus Verkleinern und Löschen, zusammen etwa zwei Stunden, und der Bestand lag bei 6293 Kontakten. 138'493 Duplikate wurden erfolgreich entfernt.
Der langsame Teil ist das Verkleinern, nicht das Löschen.
Nicht wegen des Speicherlimits, sondern wegen der Quota: 429 Too Many Requests.
Rund zwei Kontakte pro Sekunde sind das von Google erlaubte Maximum pro Verzeichnis.
Drei Eigenheiten, die Zeit gekostet haben
title ist abgeleitet, nicht gesetzt.
Ein Kontakt hat ein <title>-Element, das aussieht wie der Anzeigename.
Es wird aber aus gd:name erzeugt.
Wer beim Verkleinern gd:name entfernt und dafür <title> mitsendet,
bekommt namenlose Einträge.
Rund 1100 Kontakte waren so behandelt, bevor es auffiel.
Der Verzeichnis-Index hinkt nach. Nach den Löschungen zeigte die API 6293 Kontakte, die Oberfläche im Browser noch 15'591 und sank über Tage nur langsam. Die Suche im Verzeichnis war dagegen sofort korrekt: Ein Kontakt, der vorher 84 Mal existierte, hatte nun nur noch einen einzigen Treffer. Die Gesamtzahl ist ein separat gepflegter Zähler und als Kontrollwert unbrauchbar. Wer prüfen will, ob etwas angekommen ist, sucht einen konkreten Eintrag.
Grosse Batches scheitern anders als kleine.
Der Batch-Endpoint nimmt bis zu 100 Operationen pro Anfrage entgegen.
Solange das Limit erreicht ist, skaliert die Quotenprüfung mit der Anzahl Operationen:
Eine Anfrage mit einer Löschung ging durch, eine mit hundert nicht.
Es lohnt sich, die Batchgrösse beim Fehler 403 zu halbieren
und nach erfolgreichen Runden wieder zu verdoppeln,
statt eine feste Grösse zu wählen.
Was ich davon mitnehme
Wer in die Domain Shared Contacts schreibt, nutzt eine Datenbank ohne Betriebsanleitung. Es gibt kein Dashboard für den Füllstand, keine Warnung vor dem Limit, keine Oberfläche zum Aufräumen und mit den Tombstones eine Mechanik, die genau dann gegen einen arbeitet, wenn man sie am dringendsten bräuchte.
Zwei Dinge würde ich beim nächsten Mal von Anfang an einbauen.
Erstens eine Zählung.
Der Feed liefert openSearch:totalResults bei jeder Anfrage mit.
Ein Job, der diese Zahl protokolliert und bei ungewöhnlichem Wachstum meldet,
hätte den Vorfall in der ersten Woche sichtbar gemacht.
Zweitens eine Obergrenze für Schreiboperationen. Unsere Sync durfte pro Nacht beliebig viele Kontakte anlegen. Sie tat das 90 Nächte hintereinander, ohne dass sie etwas gebremst hätte. Inzwischen bricht sie ab, wenn ein Lauf mehr als ein Viertel des Datenbestands anlegen oder löschen will — in beide Richtungen, denn die Löschseite sowie die Bearbeitungsseite können genauso entgleisen wie die Anlageseite.